Raggruppamento logico
Raggruppa monitor HTTP, cron e browser in servizi con nome (API pagamenti, checkout, autenticazione), così il tuo team ragiona per servizi e non per singoli URL e porte.
Raggruppa i monitor nei servizi che il tuo team gestisce, poi decidi cosa succede quando uno fallisce: quale policy di escalation avvisa qualcuno, se un incidente si apre da solo e su quale status page viene pubblicato.
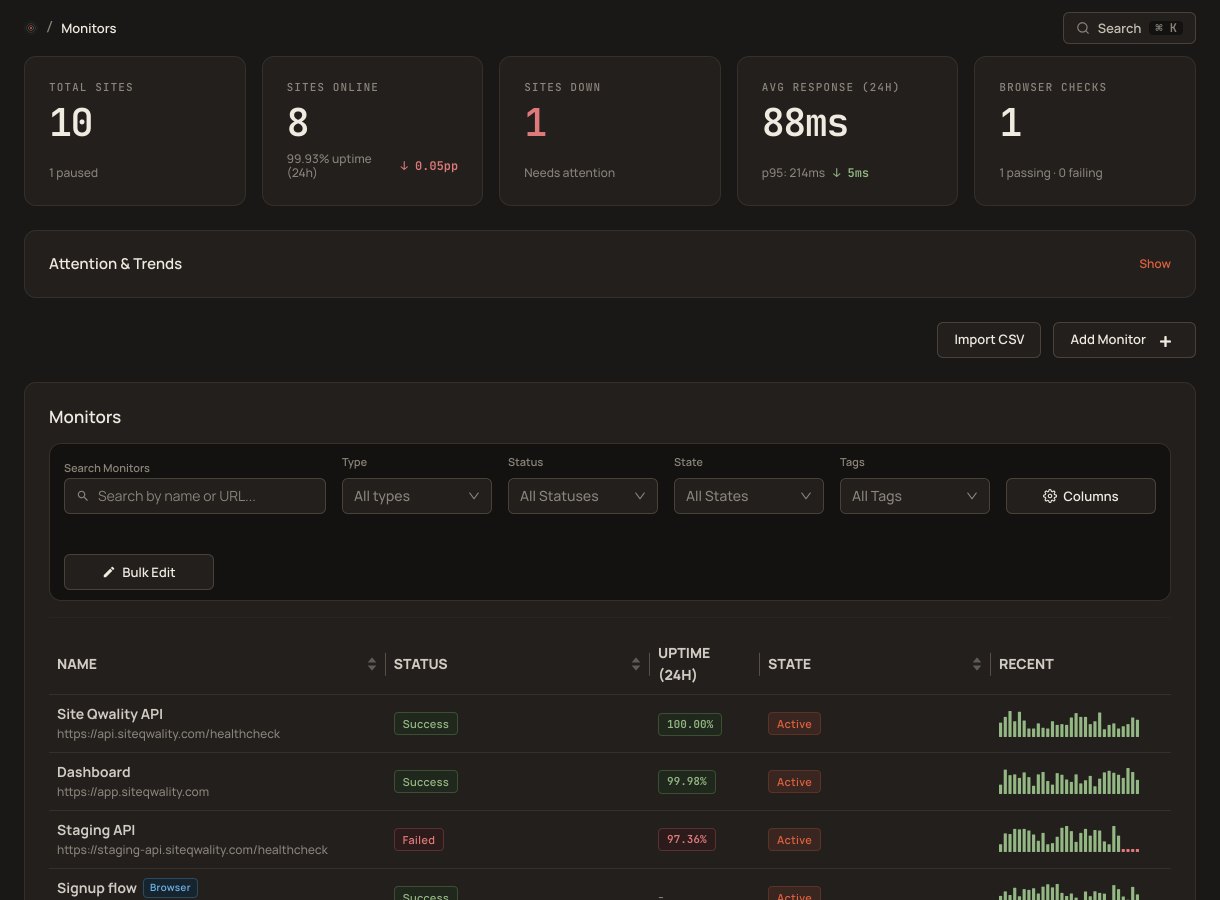
Un servizio è l'unità di cui il tuo team parla davvero: pagamenti, checkout, autenticazione. Collega i suoi monitor HTTP, cron e browser, assegnagli una policy di escalation e le impostazioni degli incidenti, e ogni guasto di quei monitor segue lo stesso piano.
Raggruppa monitor HTTP, cron e browser in servizi con nome (API pagamenti, checkout, autenticazione), così il tuo team ragiona per servizi e non per singoli URL e porte.
Assegna a ogni servizio una policy di escalation. I suoi livelli possono puntare a persone o a turni di reperibilità, così un guasto avvisa chi è di turno senza che nessuno debba cercarlo.
Lascia che il guasto di un monitor apra un incidente sul suo servizio, con la gravità che scegli. I guasti dentro la finestra di unione confluiscono nell'incidente aperto invece di aprirne uno nuovo.
Quando tutti i monitor dietro un incidente automatico tornano in salute, l'incidente si risolve da solo e la sua escalation si ferma, così nessuno deve ricordarsi di chiuderlo.
Imposta una status page su un servizio tramite l'API e gli incidenti che apre automaticamente vengono pubblicati lì, così i clienti vedono il problema senza che nessuno lo ricopi. Per ora non c'è un'impostazione nella dashboard.
Invia le notifiche degli incidenti di un servizio a un suo indirizzo email, webhook o canale Slack, oltre alle persone avvisate dalla policy di escalation. Un canale Slack come destinazione richiede un token del bot Slack incollato nella destinazione.
Ogni monitor collegato a un servizio segue il suo piano. L'incidente si apre con la gravità giusta, la policy di escalation avvisa la persona giusta e la status page impostata riceve l'incidente, senza che nessuno debba decidere sul momento.
Crea servizi, collega i loro monitor e imposta policy di escalation e impostazioni degli
incidenti tramite la REST API. Tieni lo script nel tuo repo e le modifiche passano
dal normale processo di pull request (revisione, approvazione, applicazione) invece
che da modifiche manuali in un'interfaccia. Una chiave API con scope ha bisogno di
read:services per leggere il catalogo e di write:services
per modificarlo; una chiave con accesso completo copre entrambi.
posto per monitor, escalation e impostazioni degli incidenti di un servizio
passaggi manuali per indirizzare un incidente al team giusto
gravità predefinite impostabili su un servizio: minor, major o critical
piano gratuito, catalogo dei servizi incluso fin dall'inizio
Un servizio è un gruppo con nome di monitor HTTP, cron e browser. Ha una policy di escalation, impostazioni degli incidenti (modalità di creazione, finestra di unione e gravità predefinita), destinazioni di notifica facoltative e, facoltativamente, una status page per i suoi incidenti, impostata tramite l'API. Rappresenta come il tuo team pensa all'infrastruttura, non come è organizzata fisicamente.
Dipende dalla modalità degli incidenti del servizio. In modalità automatica un incidente si apre subito; in modalità manuale aspetta che sia tu a dichiararlo. Un guasto dentro la finestra di unione confluisce nell'incidente già aperto. Gli incidenti automatici attivano la policy di escalation del servizio e, se impostata, compaiono sulla sua status page.
No. Un servizio registra i suoi monitor, la policy di escalation e le impostazioni degli incidenti. Chi viene avvisato dipende dalla policy di escalation e dai turni di reperibilità a cui punta. Le dipendenze tra servizi non sono modellate.
Sì. Imposta una status page sul servizio tramite l'API e gli incidenti che apre automaticamente vengono pubblicati lì. Gli iscritti alla status page non ricevono email per questi incidenti automatici.
Sì. Servizi, monitor collegati e destinazioni di notifica si gestiscono tutti tramite la REST API, così uno script nel tuo repo può tenere il catalogo allineato a ciò che gestisci.
Uptime, cron, synthetic, log, RUM, incidenti e pagine di stato. Piano gratuito su ogni prodotto.