Formati integrati
Le righe Apache combined, nginx, syslog RFC 5424, CSV e key=value vengono analizzate senza scrivere un pattern. Scegliere il formato e mappare i campi da conservare.
Definire regole di parsing (formati integrati o espressioni regolari con gruppi con nome) che estraggono campi dalle righe di log in testo semplice al momento dell'ingestione, prima che un singolo evento raggiunga l'explorer.
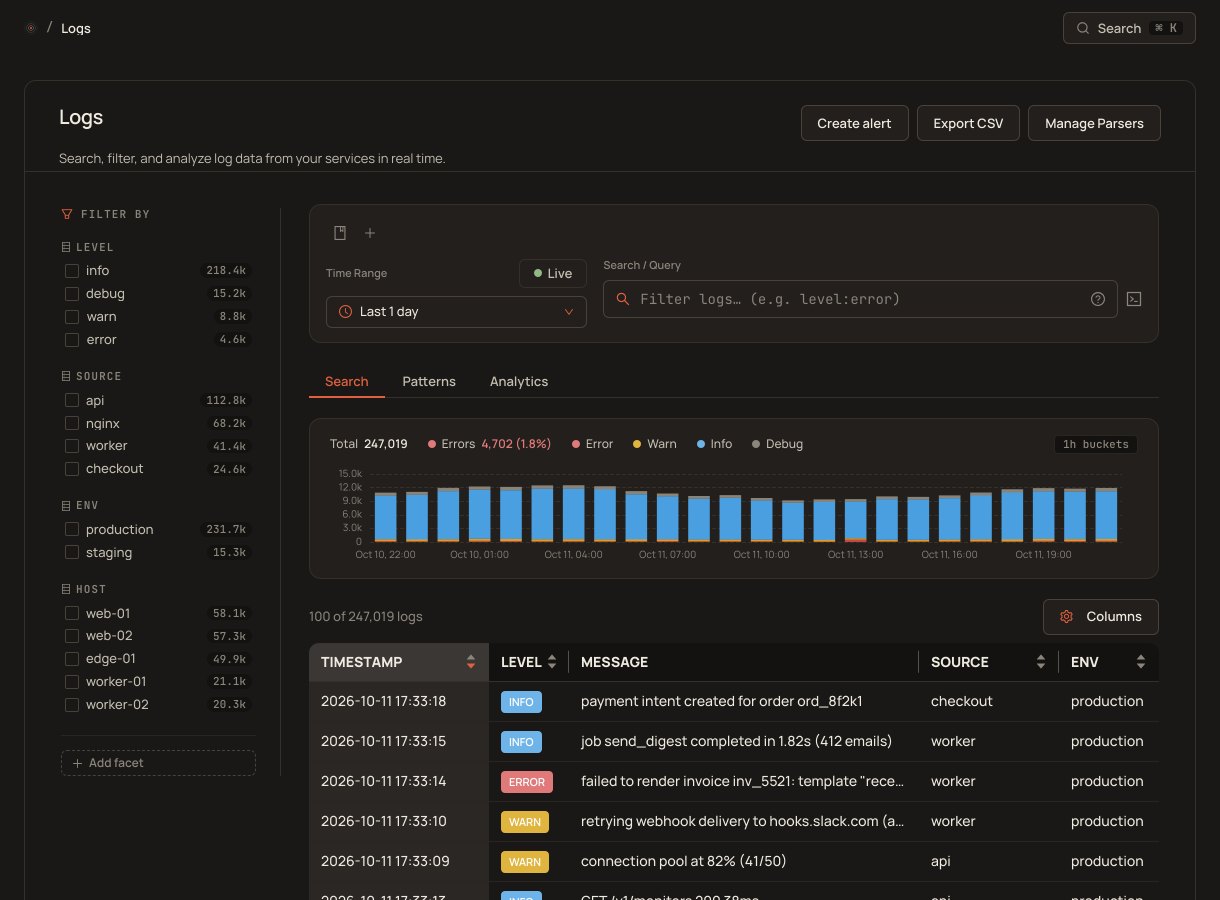
Una riga di log in testo semplice può diventare un insieme di campi con nome prima di arrivare nell'explorer. Mappare ogni valore estratto a un campo del log come level, host o source, a un tag su cui filtrare, o a metadati ricercabili. Nessuna migrazione di schema, nessuna re-indicizzazione.
Le righe Apache combined, nginx, syslog RFC 5424, CSV e key=value vengono analizzate senza scrivere un pattern. Scegliere il formato e mappare i campi da conservare.
Per tutto ciò che i formati integrati non coprono, scrivere una regex standard con gruppi di cattura con nome; ogni gruppo diventa un campo mappabile a un campo del log, a un tag o a metadati.
Incollare una riga di log di esempio, eseguirvi la regola e vedere i campi estratti e mappati. Nessun ciclo di deploy, nessun dubbio sul funzionamento della regola.
Ogni riga va alla prima regola attiva, in ordine di priorità, il cui filtro di sorgente e pattern di rilevamento corrispondono, così log di accesso e log applicativi dello stesso servizio possono usare regole diverse.
Il parsing avviene quando la riga arriva, quindi i campi estratti vengono archiviati insieme a essa e ogni ricerca successiva può usarli senza alcun backfill.
Aggiornare o sostituire una regola in qualsiasi momento. Le righe che arrivano dopo la modifica, di solito entro un minuto, usano la nuova regola, mentre le righe archiviate mantengono i campi con cui sono state analizzate.
L'editor del parser esegue la regola su una riga di log di esempio ogni volta che lo si richiede. I campi estratti e la loro destinazione appaiono subito lì: si sa che la regola è corretta prima ancora di salvarla, e si itera in secondi invece di attendere il riavvio di una pipeline.
Le regole del parser sono archiviate come risorse di primo livello che possono essere create, rilette e gestite via API. Lasciare vuoto il filtro di sorgente per coprire ogni sorgente in testo semplice, e mantenere la configurazione del parsing in source control insieme al resto dell'infrastruttura.
conservazione dei log più lunga che vendiamo oggi
formati integrati: Apache, nginx, syslog, CSV e key=value
re-ingestioni necessarie quando si modifica una regola
piano gratuito, inizia senza carta di credito
Non necessariamente. I parser integrati coprono righe Apache combined, nginx, syslog RFC 5424, CSV e key=value. Basta selezionarne uno e mappare i campi desiderati. Per i formati personalizzati è sufficiente una regex con gruppi di cattura con nome.
Al momento dell'ingestione, prima che la riga venga archiviata. I parser si applicano alle righe in testo semplice; un body JSON viene archiviato così come è stato inviato. I campi estratti vengono archiviati insieme alla riga, quindi non c'è alcuna fase di rielaborazione.
Le righe non corrispondenti vengono comunque archiviate e sono ricercabili tramite ricerca full-text. Solo l'estrazione dei campi strutturati viene saltata. Testare la regola su righe di esempio nell'editor per perfezionare il pattern prima di salvarla.
Una regola corrisponde a un nome di sorgente, oppure a tutte le sorgenti se il filtro di sorgente viene lasciato vuoto. Un pattern di rilevamento opzionale la restringe ulteriormente, così una regola può coprire molte sorgenti le cui righe condividono un formato. Aggiornare la regola una volta e ogni riga che arriva in seguito la userà.
Sì. Ogni operazione sui parser (creazione, aggiornamento, eliminazione, elenco) è disponibile tramite REST API, rendendo immediata la gestione della configurazione del parsing come parte del workflow infrastructure-as-code.
Uptime, cron, synthetic, log, RUM, incidenti e pagine di stato. Piano gratuito su ogni prodotto.