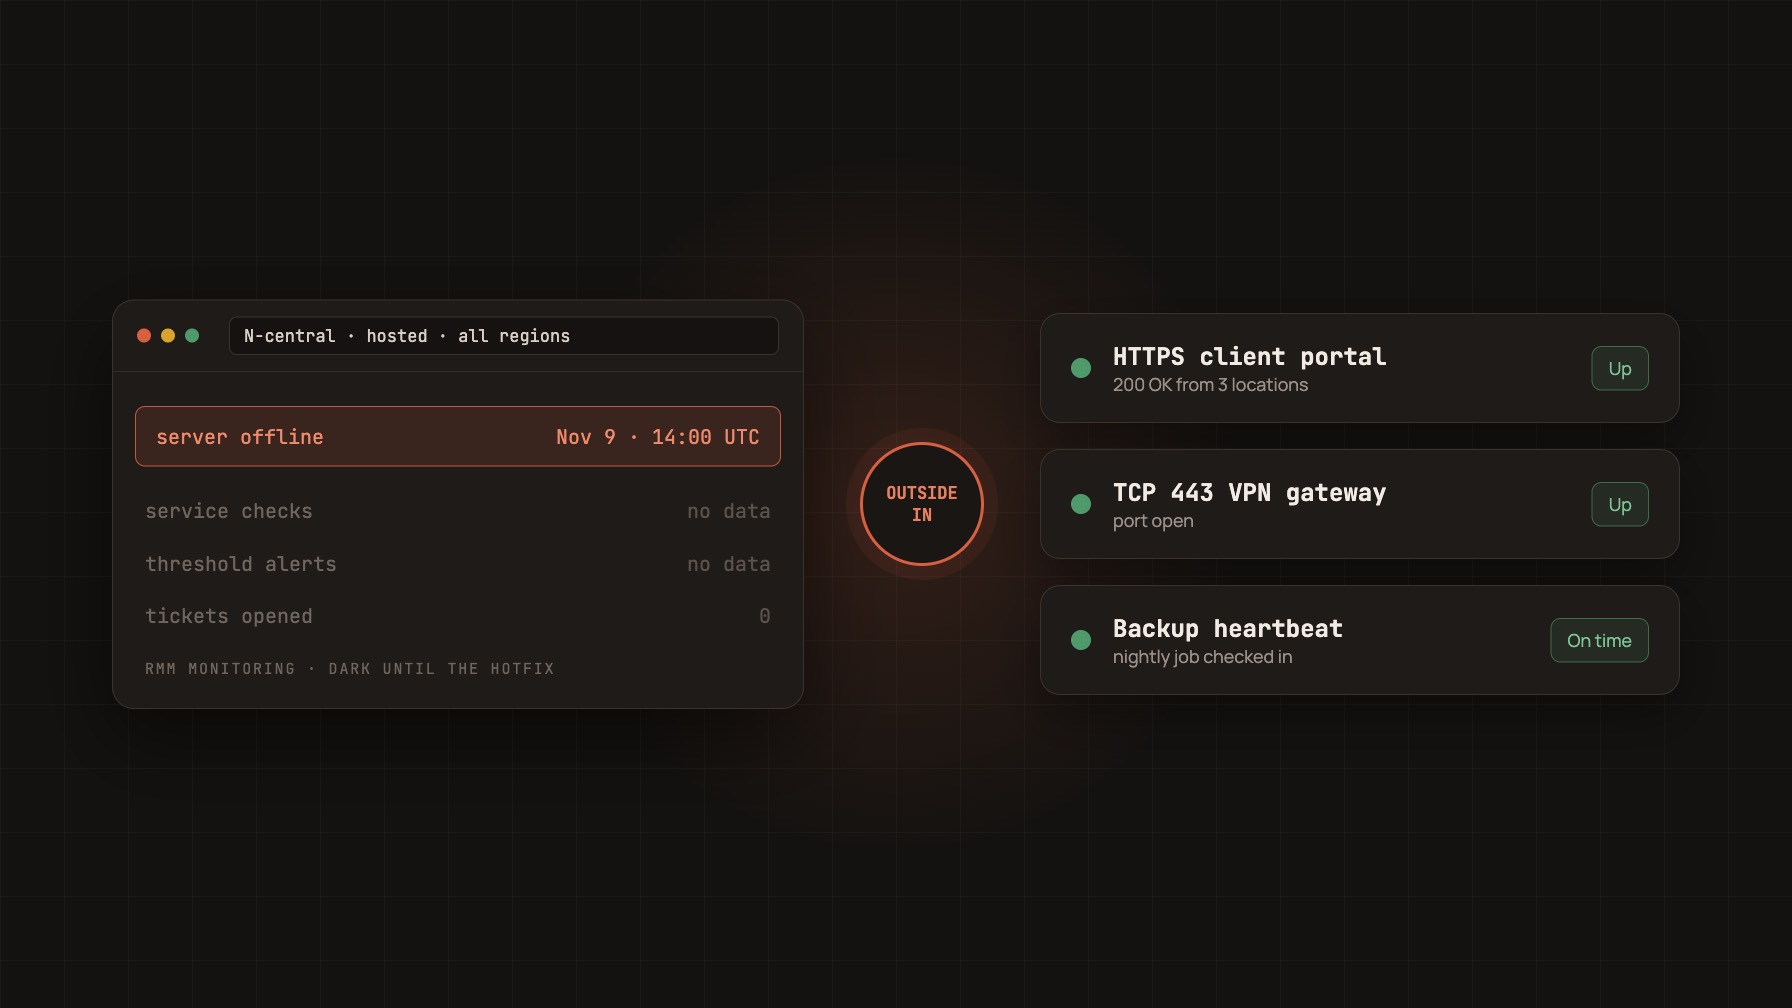
Lunedì 9 novembre 2026 N-able ha messo offline tutti gli ambienti N-central ospitati, nelle Americhe, in Europa e in Asia-Pacifico, e ha chiesto ai clienti che eseguono N-central sui propri server di spegnerli. Poche ore prima, un ricercatore indipendente aveva pubblicato exploit proof-of-concept per 33 vulnerabilità senza patch della piattaforma, con il nome Able2Shell.
N-central è la piattaforma di remote monitoring and management (RMM) che molti managed service provider usano per controllare, aggiornare e raggiungere le macchine dei propri clienti. Spegnerla è stata la scelta più sicura. Ma significa anche che, finché resta spenta, un MSP che ci fa affidamento ha perso il sistema che gli direbbe che un cliente è down. Questo articolo racconta cosa è successo, cosa funziona ancora e cosa avere già pronto che non vada offline insieme al tuo RMM.
Cosa è successo
| Ora (UTC) | Evento |
|---|---|
| 9 nov, 04:14 | Sean Bales pubblica “Able2Shell” in un repository GitHub pubblico: analisi, screenshot e script proof-of-concept per 33 vulnerabilità, raggruppate in quattro catene di exploit. Il README dice che tutte hanno funzionato, senza patch, su N-central Appliance 2026.4.0.31. |
| 9 nov, 14:00 | La pagina di stato di N-able apre un incidente di tipo Major Outage per N-central, ospitato e on-premises, in tutte e tre le regioni. |
| 9 nov, 15:15 | N-able dice di non aver visto exploit attivi. N-central ospitato è offline e ai clienti on-premises viene chiesto di “spegnere temporaneamente i propri server N-central fino a nuovo avviso”. |
| 9-10 nov | Aggiornamenti di stato verso le 21:00, 00:00, 05:00 e 09:30. N-able indica come ETA per un hotfix mezzogiorno del 10 novembre, ora della costa orientale degli USA. |
| 10 nov, 17:42 | N-able dice che la release è vicina alla disponibilità generale. |
Le falle sono gravi. La prima catena dell'analisi non richiede credenziali: finisce con comandi eseguiti sul server e, in via facoltativa, un nuovo account amministratore. Un'altra non richiede credenziali e arriva a root quando un amministratore apre una pagina di patch manomessa. Altre falle espongono credenziali o permettono a un attaccante di scrivere file sul server. Il repository non dice se N-able sia stata avvisata prima della pubblicazione.
Il README definisce 2026.4.0.31 una build pre-release e dice che la maggior parte delle vulnerabilità, “se non tutte”, dovrebbe funzionare anche sulle versioni precedenti, compresa la release attuale. Per questo N-able ha trattato ogni server come esposto.
Cosa funziona ancora
La pagina di stato di N-able elenca cosa è rimasto attivo. I suoi servizi cloud dietro N-able Login (Asset View, Patching, Vulnerability Management, scripting, policy e tagging) restano online per i partner ospitati e on-premises. Ha anche aperto in anteprima N-able.app, Take Control da Asset View e il patching Windows on demand, così i tecnici possono ancora raggiungere e aggiornare gli endpoint.
Quello che non gira è N-central stesso, e con lui il monitoraggio che un MSP ha costruito lì: controlli dei servizi, soglie, gli avvisi che generano e i ticket che quegli avvisi aprono. Con il server spento non arriva nulla, quindi non scatta nessun allarme.
La terza emergenza N-central da agosto
- Agosto. Dal 31 luglio degli attaccanti hanno sfruttato un bypass dell'autenticazione in N-central on-premises. N-able dice che un numero “limitato” di clienti è stato violato. Nei casi segnalati, gli attaccanti hanno preso il controllo di un account amministratore e usato Take Control per connettersi agli endpoint gestiti. CISA ha aggiunto CVE-2026-18556 e CVE-2026-18577 al suo catalogo Known Exploited Vulnerabilities, con una scadenza di tre giorni per le agenzie federali.
- Settembre. N-able ha rilasciato due hotfix in due giorni, il secondo per CVE-2026-86218, una falla di esecuzione di codice remoto senza autenticazione con punteggio 10,0. Huntress l'ha descritta come sfruttata. Le note di rilascio di N-able dicevano di non avere conferme di sfruttamento in produzione.
- Novembre. Able2Shell e lo spegnimento completo di N-central.
Non è solo un problema di N-able. Un server RMM può raggiungere ogni macchina che un MSP gestisce, e questo rende le piattaforme RMM un bersaglio per chiunque voglia accedere a molte reti in una volta. Ogni MSP dovrebbe prevedere che il proprio RMM possa non essere disponibile, qualunque sia il fornitore.
Il tuo RMM è anche il tuo monitoraggio
Per la maggior parte degli MSP, è l'RMM a controllare i clienti. Gli agent inviano i dati al server, e il server decide cosa merita un avviso. Funziona, finché non è il server a dover andare offline. Allora la dashboard non diventa rossa: si ferma. Il sito, il gateway VPN o il server di posta di un cliente può guastarsi durante l'interruzione, e la prima notizia che ne hai è una telefonata del cliente.
La soluzione non è un secondo RMM. È un piccolo insieme di controlli che girano fuori dal tuo stack di gestione, guardano ogni cliente da internet e avvisano direttamente le persone.
Cosa tenere fuori dall'RMM
- Un controllo dall'esterno per ogni servizio da cui dipende un cliente. Il sito e i portali in HTTPS, un gateway VPN o di desktop remoto con un controllo della porta TCP, l'invio della posta sulla porta 587 o 465, l'indirizzo pubblico di un firewall con un controllo ping, e i certificati e i domini che stanno davanti a tutto questo. Continuano a girare quando il tuo RMM no, perché non dipendono da lui.
- Più di una località. Controlla da almeno due posti e invia l'avviso solo quando il controllo fallisce da più di uno, così un singolo percorso di rete difettoso non allerta nessuno alle 3 di notte.
- Heartbeat per i job programmati. Fai chiamare a ogni job di backup dei clienti un URL heartbeat quando finisce. Se la chiamata non arriva in tempo, ricevi un avviso, che il tuo RMM sia attivo o no.
- Avvisi che arrivano direttamente alle persone. Manda questi controlli ai telefoni di reperibilità, a un canale Slack o Teams e al tuo strumento di paging, non in una coda che legge solo il tuo RMM o PSA.
- Una pagina di stato che i tuoi clienti sanno trovare. Durante un'interruzione di un fornitore come questa, i clienti vogliono sapere se i loro sistemi sono coinvolti e cosa stai facendo. Una pagina di stato ospitata fuori dal tuo stack ti permette di dirlo una volta sola. La gestione di N-able è un buon modello: un unico post riepilogativo, aggiornamenti con data e ora, cosa funziona ancora e cosa devono fare i clienti.
- Un'iscrizione alle pagine di stato dei tuoi fornitori. La pagina di N-able su uptime.n-able.com è dove è stato annunciato questo incidente, e ha un pulsante per iscriversi.
Cosa non fanno i controlli dall'esterno
Vedono ciò che vede internet. Non ti dicono se un disco si sta riempiendo, se una patch è fallita o se l'antivirus ha smesso di girare su un portatile, e non possono raggiungere un server presente solo nella rete interna del cliente. Quello resta compito dell'RMM. Inoltre non fanno nulla per la sicurezza: se il tuo server N-central era esposto, segui le indicazioni di N-able e cerca segni di compromissione.
Per i server on-premises, Huntress suggerisce di rivedere gli accessi e l'attività di autenticazione dall'8 novembre in poi, e di cercare sessioni remote sconosciute, script distribuiti di recente e nuovi account amministratore. Tieni il server offline finché N-able non conferma che è sicuro, poi applica l'hotfix. Huntress segnala che l'hotfix potrebbe non cambiare il numero di versione mostrato, quindi controlla le indicazioni di aggiornamento di N-able per sapere come verificare che sia installato.
Se gestisci i siti dei clienti
Il nostro programma partner dà a ogni tuo cliente un account Site Qwality tutto suo: controlli ogni 30 secondi da AWS, Google Cloud e Microsoft Azure, avvisi su Slack, Teams, SMS e sul tuo strumento di paging, e una pagina di stato sul dominio del cliente, con il suo brand. Ti fatturiamo una volta al mese per tutti, e nulla passa dal tuo RMM.
Fonti
- Pagina di stato di N-able: N-central Critical Security Incident (incidente 202580, aperto il 9 novembre 2026; letto il 10 novembre 2026, 19:22 UTC)
- Sean Bales: Able2Shell, N-Central N-Able (GitHub, commit del 9 novembre 2026)
- Huntress: N-able disattiva i servizi cloud dopo la divulgazione delle catene di exploit “Able2Shell” (9 Novembre 2026)
- The Hacker News: N-able mette offline il cloud di N-central dopo che un ricercatore rende pubbliche 33 zero-day con exploit PoC (10 Novembre 2026)
- Help Net Security: Gli attaccanti sfruttano una falla di N-able N-central per raggiungere gli endpoint gestiti (CVE-2026-18577) (3 Agosto 2026)
- The Register: Alle agenzie federali 3 giorni per correggere una falla di N-able sfruttata attivamente (4 Agosto 2026)
- Huntress: Vulnerabilità critica di N-able N-central e sfruttamento attivo