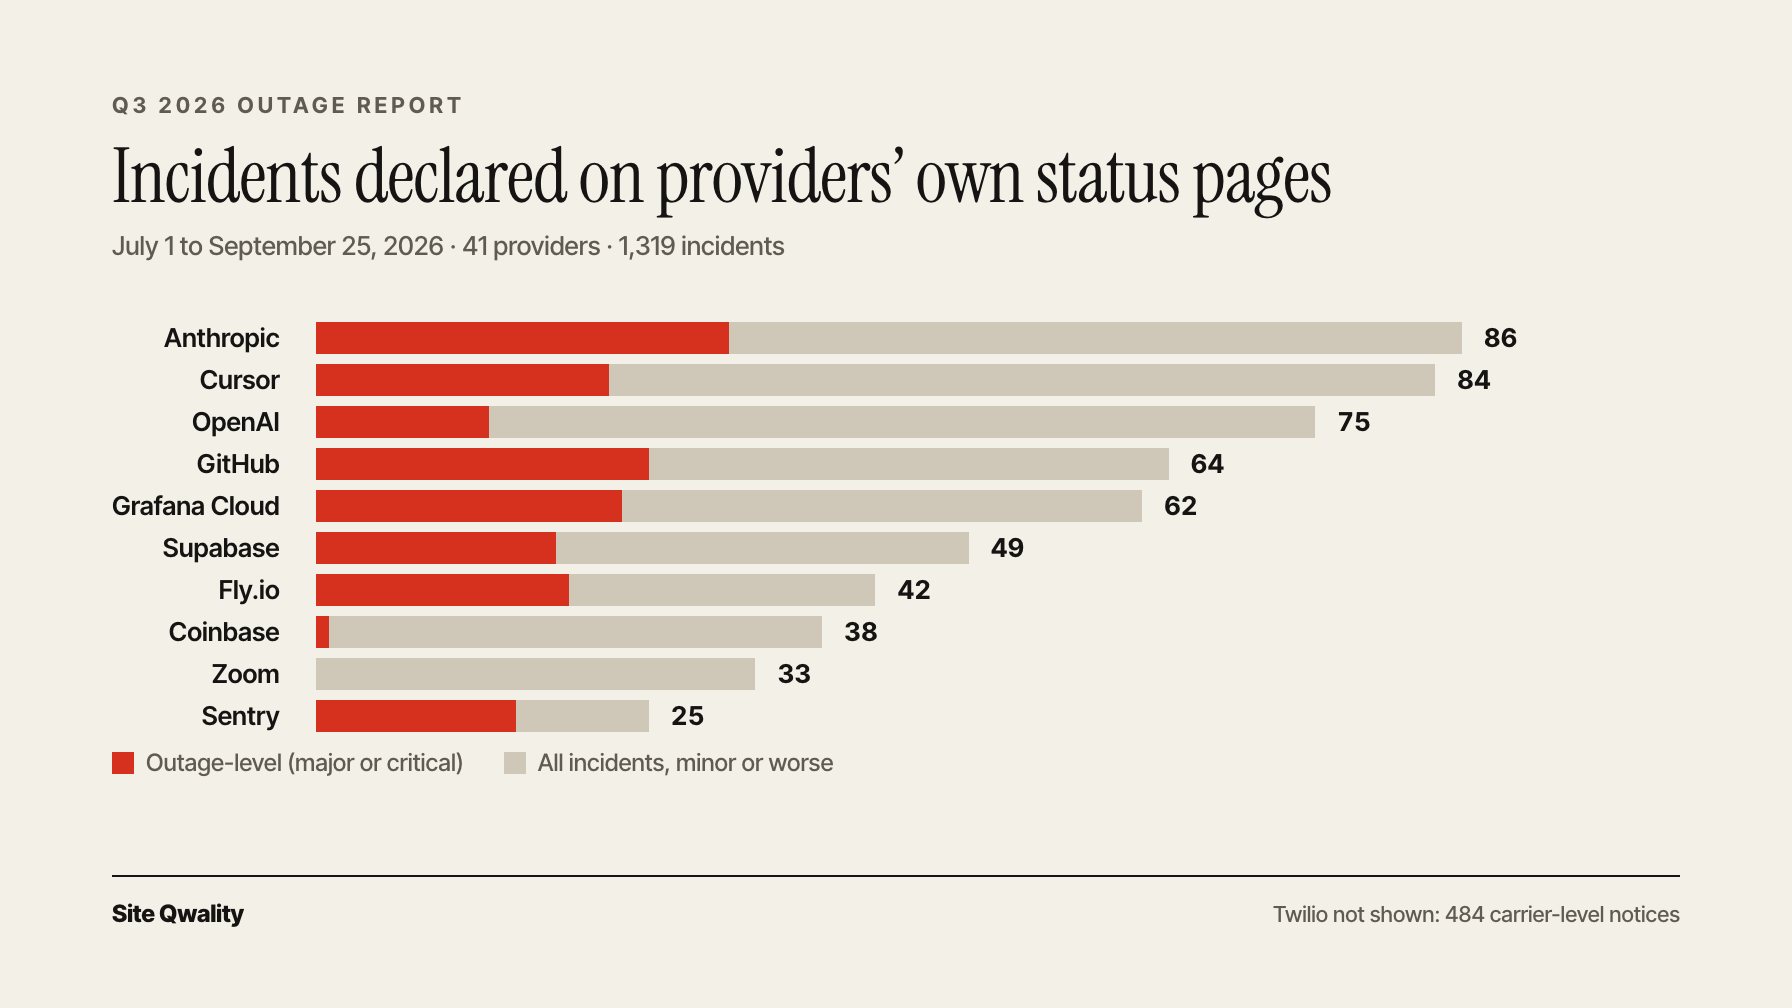
Ogni grande provider cloud, AI e SaaS pubblica i propri incidenti su una pagina di stato pubblica. Abbiamo raccolto tutti gli incidenti dichiarati da 41 di loro tra il 1° luglio e il 25 settembre 2026, 87 giorni, e abbiamo contato cosa hanno comunicato ai propri clienti. Ecco com'è andato il terzo trimestre, direttamente dai provider.
Risultati principali
- 1.319 incidenti in 87 giorni. I 41 provider hanno dichiarato 1.319 incidenti classificati come minori o peggiori. Solo Twilio ne conta 484, perché pubblica singolarmente ogni ritardo di consegna a livello di carrier. Senza Twilio, gli altri 40 ne hanno dichiarati 835.
- 280 erano di livello interruzione. Il provider ha classificato 280 incidenti come interruzione maggiore o critica, non come semplice degrado delle prestazioni. 79 erano critici.
- I tre principali strumenti AI hanno dichiarato 245 incidenti in tutto. Anthropic (86), Cursor (84) e OpenAI (75) hanno dichiarato insieme un incidente circa ogni 8,5 ore, 66 dei quali di livello interruzione. La categoria AI nel suo complesso è 7 dei 40 provider (escluso Twilio), ma il 32% dei loro incidenti.
- Anthropic ha dichiarato più incidenti di livello interruzione di qualsiasi altro provider monitorato (31), seguita da GitHub (25), Grafana Cloud (23) e Cursor (22).
- GitHub ha dichiarato più incidenti critici (12), davanti a Snowflake (10) e Sentry (7).
- L'incidente tipico è durato circa un'ora e mezza. L'incidente mediano, escluse le notifiche sui carrier di Twilio, è durato 88 minuti dal primo post alla risoluzione, e il 64% è durato più di un'ora.
- Il tuo provider ha dei provider. Almeno 10 incidenti di GitHub citavano nel titolo un modello AI di terze parti, da “Elevated errors on Fable 5 due to upstream provider” a “Elevated rate of errors for OpenAI models provided by Copilot”.
Tutti i provider, in ordine di incidenti dichiarati
“Livello interruzione” significa che il provider stesso ha classificato l'incidente come maggiore o critico. La durata mediana va dal primo post alla notifica di risoluzione. Ogni nome rimanda alla pagina di stato da cui provengono i dati.
| Provider | Categoria | Incidenti | Livello interruzione | Critici | Durata mediana |
|---|---|---|---|---|---|
| Twilio | Comunicazione | 484 | 2 | 0 | 5h 49m |
| Anthropic (Claude) | IA | 86 | 31 | 5 | 1h 04m |
| Cursor | IA | 84 | 22 | 5 | 1h 12m |
| OpenAI | IA | 75 | 13 | 3 | 1h 25m |
| GitHub | Strumenti per sviluppatori | 64 | 25 | 12 | 1h 22m |
| Grafana Cloud | Strumenti per sviluppatori | 62 | 23 | 6 | 2h 10m |
| Supabase | Cloud e hosting | 49 | 18 | 4 | 2h 02m |
| Fly.io | Cloud e hosting | 42 | 19 | 3 | 1h 19m |
| Coinbase | Pagamenti e commercio | 38 | 1 | 0 | 1h 11m |
| Zoom | Comunicazione | 33 | 0 | 0 | 2h 02m |
| Sentry | Strumenti per sviluppatori | 25 | 15 | 7 | 3h 00m |
| Vercel | Cloud e hosting | 25 | 10 | 1 | 1h 07m |
| DigitalOcean | Cloud e hosting | 23 | 4 | 2 | 5h 29m |
| Snowflake | Cloud e hosting | 22 | 17 | 10 | 1h 56m |
| CircleCI | Strumenti per sviluppatori | 22 | 2 | 1 | 1h 20m |
| Notion | Produttività | 21 | 5 | 0 | 1h 12m |
| Discord | Comunicazione | 17 | 16 | 2 | 1h 22m |
| Render | Cloud e hosting | 16 | 10 | 4 | 58m |
| Jira | Strumenti per sviluppatori | 15 | 6 | 3 | 2h 32m |
| MongoDB Atlas | Cloud e hosting | 15 | 6 | 0 | 1h 50m |
| Datadog | Strumenti per sviluppatori | 12 | 3 | 1 | 56m |
| Netlify | Cloud e hosting | 10 | 4 | 1 | 26m |
| Mailgun | Comunicazione | 9 | 5 | 3 | 1h 22m |
| Linode | Cloud e hosting | 9 | 0 | 0 | 2h 11m |
| Pinecone | IA | 8 | 6 | 1 | 2h 56m |
| Perplexity | IA | 8 | 5 | 3 | 1h 01m |
| Zapier | Produttività | 8 | 2 | 0 | 3h 30m |
| npm | Strumenti per sviluppatori | 7 | 1 | 0 | 1h 39m |
| 1Password | Identità e sicurezza | 5 | 3 | 1 | 46m |
| Dropbox | Produttività | 5 | 1 | 0 | 1h 54m |
| Runway | IA | 5 | 1 | 1 | 1h 01m |
| Weights & Biases | IA | 5 | 1 | 0 | 56m |
| Duo Security | Identità e sicurezza | 4 | 0 | 0 | 9h 20m |
| New Relic | Strumenti per sviluppatori | 2 | 1 | 0 | 1h 26m |
| Bitbucket | Strumenti per sviluppatori | 2 | 0 | 0 | 1h 06m |
| Airtable | Produttività | 1 | 1 | 0 | 1h 42m |
| Figma | Produttività | 1 | 1 | 0 | 4h 11m |
| Atlassian Statuspage | Strumenti per sviluppatori | 0 | 0 | 0 | – |
| HubSpot | Produttività | 0 | 0 | 0 | – |
| Shopify | Pagamenti e commercio | 0 | 0 | 0 | – |
| Trello | Produttività | 0 | 0 | 0 | – |
Leggi i numeri con attenzione: misurano la trasparenza tanto quanto l'affidabilità
Il numero di incidenti è ciò che un provider ha scelto di rendere noto, e i provider comunicano in modi molto diversi. Twilio pubblica un incidente separato ogni volta che la consegna degli SMS rallenta su una rete mobile in un paese: 484 incidenti in questo trimestre, solo 2 di livello interruzione. Shopify e Trello non hanno pubblicato alcun incidente nel periodo, e HubSpot ha pubblicato solo avvisi informativi. Un lungo elenco su una pagina di stato spesso significa che un provider è trasparente su problemi piccoli e circoscritti, non che sia meno affidabile di un concorrente più silenzioso.
Quindi confronta i provider all'interno della stessa categoria, dai più peso alla colonna del livello outage che al totale e guarda con sospetto uno zero. I numeri restano utili: sono il resoconto del trimestre fatto dai provider stessi, e è l'unico che hai.
I provider di AI hanno retto il carico maggiore
La categoria AI si è divisa in due. Anthropic, Cursor e OpenAI hanno dichiarato 245 incidenti, mentre gli altri quattro provider di AI che abbiamo potuto includere (Pinecone, Perplexity, Runway e Weights & Biases) ne hanno dichiarati 26 in totale. I tre grandi sono anche gli strumenti che gli sviluppatori ormai integrano nei propri editor, nelle pipeline CI e nei prodotti, quindi i loro incidenti raramente restano solo loro.
Molti di questi incidenti erano circoscritti: errori elevati su un modello, su una singola superficie come un'app desktop o un agente di coding, oppure su una regione. Ed è proprio per questo che sono difficili da pianificare. Un'interruzione parziale sull'unico modello che la tua funzionalità chiama è un'interruzione totale per la tua funzionalità.
Il provider del tuo provider
La pagina di stato di GitHub mostra come funziona oggi la catena delle dipendenze. Almeno 10 dei suoi 64 incidenti del trimestre citavano nel titolo un modello o un provider di AI di terze parti, tra cui disponibilità ridotta dei modelli GPT, errori su Gemini e un incidente del provider di modelli di Copilot con Grok. DigitalOcean ha pubblicato incidenti per i modelli Llama, DeepSeek e Kimi in hosting, e Twilio ha registrato timeout delle funzionalità Flex AI su OpenAI. Nessuna di queste aziende ha dovuto subire un guasto alla propria infrastruttura perché i clienti vedessero errori.
Cosa hanno rilevato i nostri controlli
Le pagine di stato dicono cosa ha dichiarato un provider. Per vedere cosa riceve davvero un client, inviamo anche una richiesta non autenticata ogni 10 minuti da AWS us-east-1 a 20 endpoint API di produzione, tra cui GitHub, Stripe, npm, PyPI, Cloudflare e otto provider di AI. Tra il 13 agosto e il 25 settembre sono stati circa 6.300 controlli per endpoint.
- 15 endpoint su 20 hanno risposto a ogni controllo esattamente come previsto.
- L'API REST di GitHub ha fallito 13 controlli, 12 con HTTP 504 e 1 con HTTP 500, distribuiti su otto giorni. Sono pochissimi rispetto ai 64 incidenti sulla pagina di stato di GitHub, perché la maggior parte riguardava una singola funzionalità come Actions o un modello di Copilot, non l'API che ogni integrazione chiama.
- Un controllo fallito non è sempre un'interruzione. L'API di Perplexity ha risposto a 193 dei nostri controlli con HTTP 429, “too many requests”. L'API era attiva e ci stava applicando il rate limiting. Un monitor che considera downtime ogni codice di stato inatteso avrebbe registrato circa 32 ore di interruzione mai avvenuta.
- Il resto erano guasti di rete isolati: due timeout ciascuno per le API di Fastly e Meta Llama, e una connessione TCP fallita verso l'API di Spotify.
Una risposta non equivale a un servizio funzionante. I nostri controlli sono volutamente non autenticati, quindi non vedono mai gli errori che compaiono solo dopo il login, quando chiami un modello. Per questo i nostri numeri sono più alti di quelli di alcuni provider: l'API di DeepSeek ha risposto a tutti i nostri controlli, mentre la sua pagina di stato riporta un uptime dal 99,66% al 99,89% per le sue API negli stessi mesi circa. Sono vere entrambe, e la seconda è quella che conta per un'app che chiama il modello.
Puoi vedere questi controlli in tempo reale sulla nostra bacheca di stato pubblica e cercare qualsiasi servizio nelle nostre pagine È down?.
Cosa fare con questi dati
- Monitora l'endpoint che chiami, non la pagina di stato del fornitore. Una pagina di stato arriva in ritardo sul guasto e ne descrive il punto di vista del fornitore. Ne abbiamo spiegato il motivo in Your Provider’s Status Page Is the Last Place You’ll Learn You’re Down. Un controllo sull'API e sul modello esatti da cui dipendi ti dice cosa stanno per vedere i tuoi utenti.
- Decidi in anticipo cosa significa “sano” per ogni dipendenza. Un 401, un 404 o un 429 possono essere risposte perfettamente sane da un'API a cui non sei autenticato. Configura i codici attesi, o verrai allertato per i rate limit.
- Pianifica per i guasti circoscritti. Molti incidenti in questi dati hanno colpito un modello, una funzionalità o una regione. Fallback a quel livello (un secondo modello, una seconda regione, un nuovo tentativo in coda) coprono molti più incidenti reali di un failover multi-cloud completo.
- Scoprilo prima dei tuoi clienti. Nel New Relic 2026 Observability Forecast, il 42% delle organizzazioni viene ancora a sapere delle interruzioni tramite controlli manuali o reclami dei clienti, e un'interruzione ad alto impatto richiede in media 41 minuti solo per essere rilevata (New Relic).
Tieni d'occhio le API da cui dipende il tuo prodotto
Site Qwality controlla qualsiasi endpoint di cui hai bisogno, con i codici di stato che definisci sani, e ti avvisa su Slack, email, SMS o webhook nel momento in cui smette di rispondere. Si inizia gratis, nessuna carta richiesta.
Inizia gratisMetodologia
- Fonte. La pagina di stato pubblica di ciascun provider, raccolta il 26 settembre 2026. Per le pagine ospitate su Atlassian Statuspage abbiamo usato il feed della cronologia incidenti della pagina, che elenca ogni incidente degli ultimi tre mesi. Per le pagine ospitate su incident.io abbiamo usato il feed pubblico degli incidenti della pagina.
- Periodo. Incidenti iniziati tra il 1° luglio e il 25 settembre 2026 (UTC).
- Gravità. Livelli di impatto di Statuspage come impostati dal provider (minor, major, critical). I livelli di incident.io sono stati mappati così: degraded performance a minor, partial outage a major e full outage a critical. “Livello outage” significa major o critical. Gli avvisi informativi e le manutenzioni programmate sono esclusi.
- Durata. Dall'inizio dell'incidente alla sua risoluzione, come mostrato sulla pagina di stato, al minuto. Gli incidenti ancora aperti il 26 settembre sono conteggiati ma esclusi dalle mediane.
- Quali provider sono inclusi. Solo i provider la cui cronologia pubblicata copre dimostrabilmente l'intero periodo. Non inclusi: Cloudflare, Fastly, Hugging Face, Together AI, DeepSeek, Mistral AI, xAI, Midjourney, Replicate, Auth0, Adyen e Intercom, di cui non abbiamo potuto recuperare la cronologia degli incidenti in un formato leggibile da una macchina; e Cohere, Groq, ElevenLabs, Fireworks AI, Stability AI, Miro e Square, la cui cronologia attuale della pagina di stato inizia dopo il 1° luglio, quindi i loro conteggi sarebbero incompleti. SendGrid condivide la pagina di stato di Twilio ed è conteggiato una sola volta, come Twilio.
- I nostri controlli. Una richiesta HTTP non autenticata ogni 10 minuti da AWS us-east-1 per endpoint, dal 13 agosto al 25 settembre 2026, con la risposta non autenticata di ciascun endpoint (per esempio 401 o 404) configurata come sana.
Come usare questi dati
Puoi usare queste cifre nei tuoi contenuti. Cita “Site Qwality Q3 2026 Outage Report” con un link a questa pagina. Il dataset completo è disponibile come download CSV.